L’intelligenza artificiale sa davvero spiegare quello che fa?
Quando un sistema di intelligenza artificiale risponde a una domanda, la sua sicurezza può essere impressionante. Ma c’è una differenza enorme tra fornire una risposta convincente e sapere spiegare perché quella risposta è stata prodotta. È su questo confine che si concentra il lavoro di Jacob Andreas, ricercatore del MIT, raccontato in un approfondimento pubblicato il 17 novembre 2026. L’obiettivo non è semplicemente rendere più eloquenti i chatbot: è studiare sistemi capaci di comunicare in modo accurato ciò che hanno imparato e i propri limiti. Una sfida importante, soprattutto quando le decisioni automatiche entrano in contesti delicati.
Il problema della scatola nera
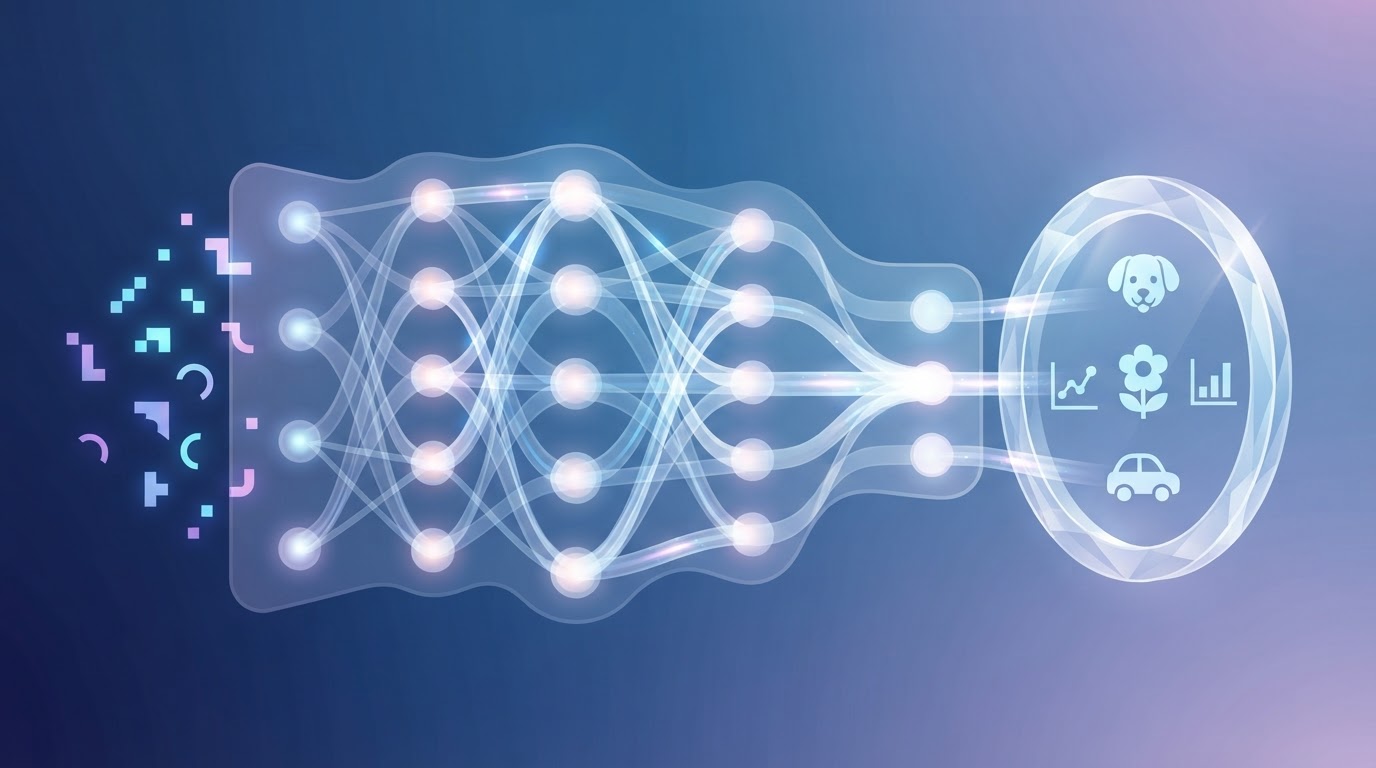
I modelli di deep learning non sono programmi tradizionali nei quali un ingegnere scrive una sequenza trasparente di regole. Durante l’addestramento, milioni o miliardi di parametri vengono modificati per riconoscere regolarità nei dati. Il risultato può essere efficace senza che una persona riesca a ricostruire facilmente la catena di rappresentazioni interne. Un modello può riconoscere un’immagine, tradurre un testo o suggerire una soluzione, ma individuare quali informazioni abbiano pesato davvero nella risposta è un’altra questione. Gli strumenti di interpretabilità cercano di aprire questa scatola nera attraverso analisi delle attivazioni, esperimenti controllati e verifiche sul comportamento. Nessuna singola tecnica offre però una spiegazione completa e infallibile.
La proposta studiata al MIT
Andreas, professore associato al Dipartimento di Electrical Engineering and Computer Science e membro del CSAIL, esplora la possibilità che i modelli imparino a descrivere ciò che sanno in un linguaggio comprensibile. L’idea è interessante perché sposta parte del lavoro dalla sola ispezione esterna del modello alla capacità di comunicazione del sistema stesso. Non significa che basti chiedere a un chatbot «perché hai risposto così?» per ottenere una descrizione fedele dei processi interni. Al contrario, proprio la fedeltà della spiegazione è il problema da risolvere. Un modello linguistico può produrre una giustificazione plausibile anche quando quella giustificazione non riflette il meccanismo che ha determinato l’output.
Dalle parole alle rappresentazioni interne
Il punto di partenza scientifico è lo studio del linguaggio e dell’apprendimento. Come fa una macchina ad associare parole e frasi a concetti, relazioni e informazioni sul mondo? E come può condividere queste rappresentazioni con una persona senza deformarle? La ricerca di Andreas attraversa questi interrogativi da anni, dalla traduzione automatica alle architetture neurali moderne. Comprendere il linguaggio come interfaccia tra esseri umani e sistemi automatici significa anche chiedersi quanto una descrizione testuale corrisponda effettivamente a una conoscenza interna. Se il modello dichiara di non sapere qualcosa, oppure segnala un’incertezza, vorremmo che quella dichiarazione fosse verificabile, non una formula imparata per sembrare prudente.
Perché la verifica è fondamentale
Immaginiamo un sistema che aiuta a valutare un documento tecnico. Il suo riepilogo potrebbe essere corretto, ma la spiegazione potrebbe citare elementi irrilevanti oppure trascurare la prova decisiva. Per giudicare l’affidabilità non basta confrontare lo stile delle frasi. Servono esperimenti che modifichino gli input, misurino come cambiano le risposte e confrontino le dichiarazioni del modello con il suo comportamento osservabile. Una spiegazione dovrebbe resistere a controlli indipendenti, essere sensibile alle informazioni davvero importanti e indicare le condizioni nelle quali il sistema potrebbe sbagliare. Sono criteri metodologici, non capacità già dimostrate universalmente dalla ricerca descritta nel profilo del MIT.
Un obiettivo diverso dal semplice ragionamento scritto
Negli ultimi anni molte interfacce AI hanno iniziato a mostrare passaggi intermedi, riepiloghi del ragionamento o descrizioni delle operazioni svolte. Questi testi possono aiutare l’utente a seguire un processo, ma non devono essere confusi automaticamente con una finestra fedele sul funzionamento della rete neurale. Una spiegazione generata dopo la risposta può essere una ricostruzione narrativa. Una traccia di strumenti effettivamente utilizzati, invece, documenta azioni osservabili ma non esaurisce il funzionamento interno del modello. Distinguere i due livelli è essenziale: trasparenza operativa e interpretabilità scientifica sono obiettivi collegati, non sinonimi.
Le applicazioni possibili
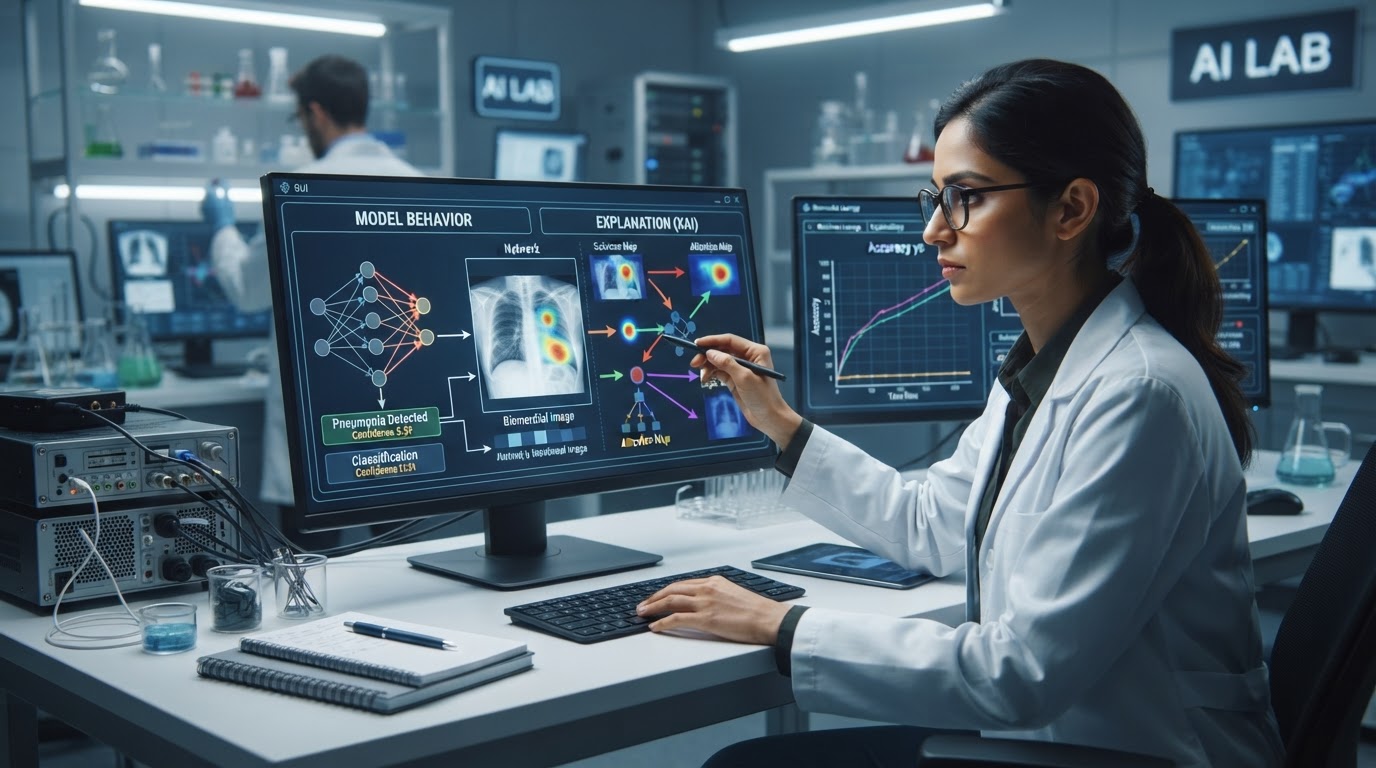
Il valore di sistemi più interpretabili emergerebbe soprattutto dove una decisione richiede responsabilità. Nella ricerca scientifica, una spiegazione verificabile potrebbe aiutare a capire quali ipotesi guidano una previsione. Nella progettazione industriale potrebbe rendere più facile identificare assunzioni fragili. Nell’istruzione potrebbe aiutare studenti e docenti a distinguere comprensione autentica e risposte memorizzate. In medicina, finanza e pubblica amministrazione servirebbero comunque validazioni specifiche, supervisione umana e regole appropriate: la capacità di spiegarsi non rende automaticamente un modello sicuro o autorizzato a decidere.
Cosa è stato dimostrato e cosa no
L’articolo del MIT del 17 novembre è un profilo di ricerca, non l’annuncio di un nuovo prodotto pronto per il mercato né il resoconto di un singolo esperimento clinico. Descrive un programma scientifico e le domande che lo guidano. Non presenta una percentuale universale di accuratezza delle spiegazioni, né prova che i grandi modelli linguistici possano già raccontare in modo fedele ogni loro processo interno. È una distinzione che vale la pena mantenere: l’interesse della direzione di ricerca non autorizza a trasformare un obiettivo in un risultato acquisito.
Il vero passo avanti sarebbe imparare a dubitare delle spiegazioni
C’è una contraddizione affascinante in questa sfida. Abbiamo costruito macchine capaci di dialogare in maniera sempre più naturale, ma proprio quella naturalezza rischia di farci attribuire loro una consapevolezza dei propri meccanismi che non è stata dimostrata. La domanda giusta non è se l’AI sappia raccontare una bella storia sul proprio funzionamento. È se quella storia possa essere controllata, smentita e migliorata con metodi scientifici. Forse la prossima frontiera dell’intelligenza artificiale affidabile non sarà soltanto ottenere risposte migliori, ma imparare a riconoscere quando una spiegazione è davvero una spiegazione.

