«Non rovesciare il caffè sul computer». È una frase semplice, ma contiene molto più di un ordine: significa anche che gli oggetti elettronici vanno protetti dai liquidi. Noi arriviamo a questa conclusione quasi senza pensarci. Per un robot, invece, passare dall’istruzione particolare alla regola generale è un problema tecnico tutt’altro che banale. Il 9 novembre 2026 il MIT ha presentato FLEX, un sistema di apprendimento che prova ad affrontarlo.
Il punto non è capire le parole, ma le intenzioni
Un assistente robotico può riconoscere una tazza, un computer e un telefono. Può anche calcolare un percorso che eviti un ostacolo. Ma riconoscere oggetti e seguire istruzioni non equivale a capire perché una persona ha dato una certa indicazione. Se gli chiediamo di non versare il caffè sul portatile, vorremmo che evitasse anche il telefono vicino, senza dover compilare un elenco completo di apparecchiature elettroniche.
È qui che il progetto FLEX cerca di intervenire. I ricercatori del MIT e della New York University non propongono un robot capace di leggere la mente. Propongono una procedura che modifica la rappresentazione delle caratteristiche importanti nell’ambiente sulla base di poche correzioni espresse in linguaggio naturale. Il nome completo del lavoro è Flexible Language-Guided Representation Editing for Adaptive Robot Behavior.
La differenza è sottile ma sostanziale. Un comando non viene trattato soltanto come un vincolo locale, valido per il singolo oggetto citato. Diventa un possibile indizio di una preferenza più ampia: proteggere l’elettronica dai liquidi, evitare oggetti fragili quando si trasporta qualcosa di pesante, tenere una fiamma lontana dai materiali infiammabili.
Tre passaggi: Add, Generalize, Mask
La procedura descritta dal gruppo si articola in tre fasi. La prima, Add, aggiunge una nuova caratteristica all’elenco di quelle che il robot considera quando pianifica i movimenti. Se una persona dice «Non far cadere la palla sulla tazza», il sistema registra che quella tazza è un elemento da evitare. Questo passaggio è vicino alle tecniche già utilizzate in precedenza.
La seconda fase, Generalize, è il cuore della proposta. Un modello linguistico cerca una categoria o una regola che colleghi gli esempi ricevuti. Nel caso della tazza, potrebbe ricavare la necessità di proteggere gli oggetti fragili. Nel caso del caffè, il modello può generalizzare il rischio per l’elettronica. La notizia importante non è che un modello linguistico conosca questi concetti, ma che il sistema li trasferisca alla pianificazione del movimento.
La terza fase, Mask, affronta un problema molto concreto: le case cambiano continuamente. Un oggetto può essere spostato, una stanza può essere riordinata, un ostacolo può non esserci più. Il sistema di visione del robot identifica gli elementi assenti e li esclude dall’elenco delle caratteristiche rilevanti. Secondo il MIT, l’intera procedura richiede circa cinque secondi nei test descritti.
Dalla tazza di caffè alla candela
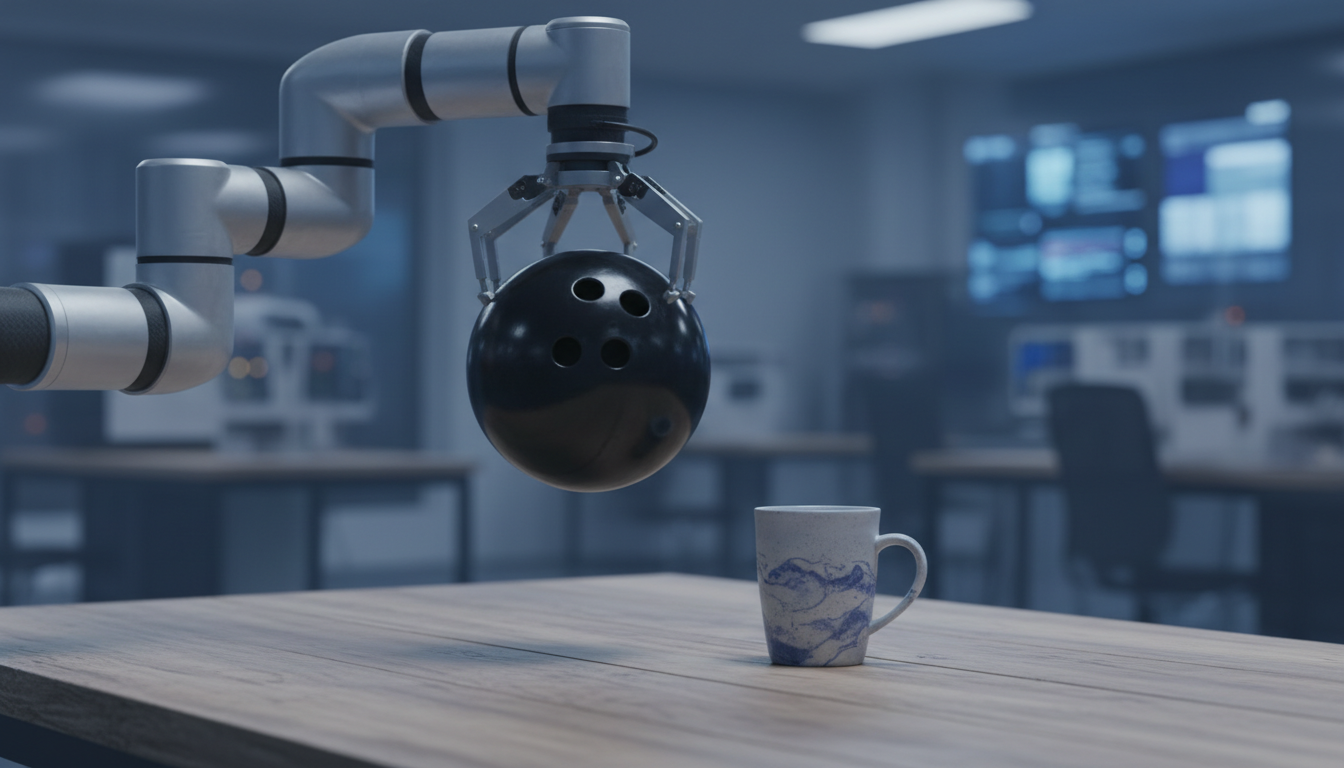
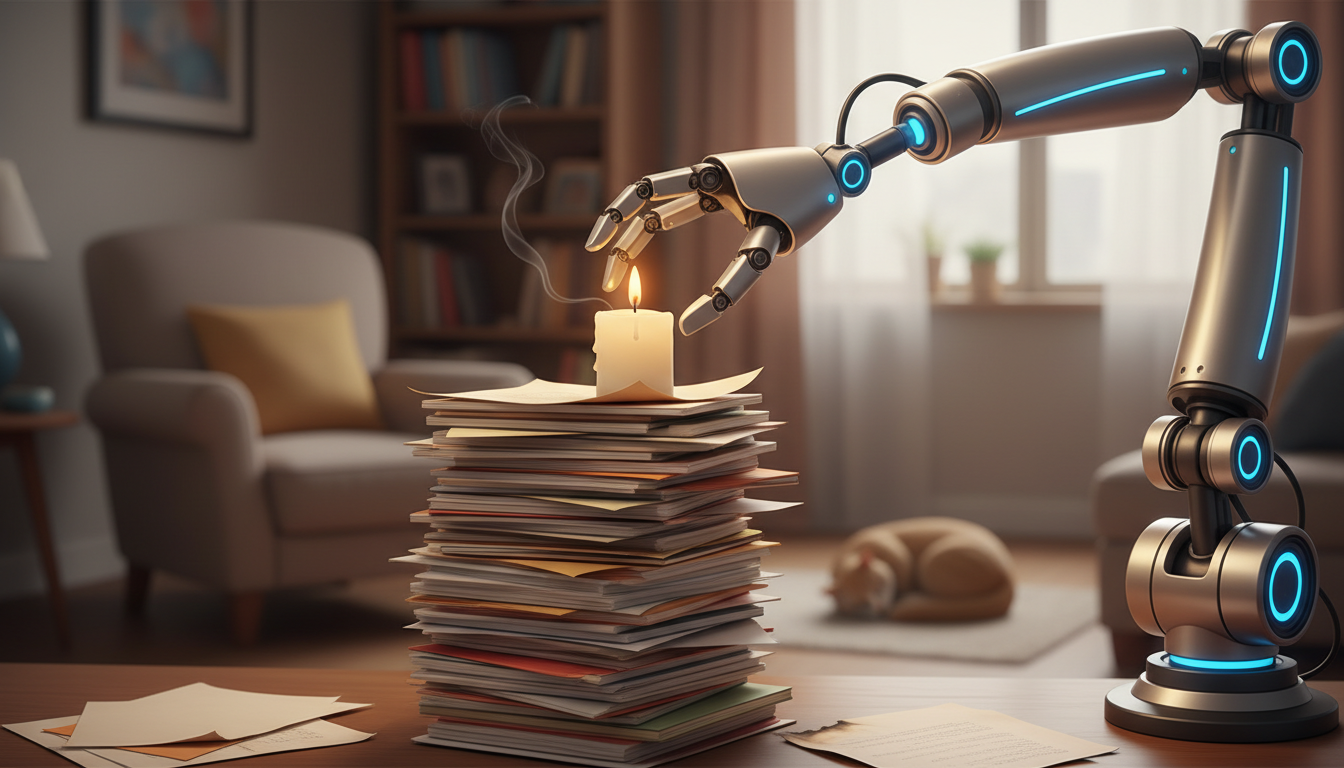
Gli esperimenti raccontati dal MIT sono stati svolti in ambienti simulati con un braccio robotico virtuale. I ricercatori hanno considerato tre compiti: servire una tazza di caffè, spostare una candela e trasportare una palla da bowling. I volontari intervenivano digitando correzioni in linguaggio naturale. Non si tratta, quindi, di una dimostrazione di robot domestici autonomi già funzionanti nelle nostre case.
Quando una persona indicava di non rovesciare il caffè sul computer, il sistema estendeva l’attenzione ad altri dispositivi elettronici. Quando veniva segnalato il pericolo di una candela vicino alla carta, la pianificazione teneva conto anche della categoria degli oggetti infiammabili. Nel caso della palla da bowling, il robot poteva considerare la fragilità degli oggetti presenti lungo il percorso.
Questi esempi sono interessanti perché mostrano un passaggio da una lista di divieti a una rappresentazione più compatta delle preferenze. Un sistema che accumula istruzioni letterali rischia di diventare difficile da aggiornare. Un sistema che ricava categorie può adattarsi meglio, almeno quando la generalizzazione è corretta e il contesto è sufficientemente chiaro.
Il ruolo dei grandi modelli linguistici
FLEX integra un modello linguistico di grandi dimensioni; nello studio è stato utilizzato GPT-4o. L’LLM non sostituisce il controllo fisico del robot e non esegue da solo tutti i calcoli della traiettoria. Contribuisce invece a individuare le relazioni semantiche tra gli oggetti e i rischi impliciti nelle istruzioni. È una distinzione importante: conoscere il significato di «fragile» non basta per manipolare davvero un oggetto senza romperlo.
I robot utilizzano modelli geometrici, sistemi di visione e algoritmi di pianificazione. Il linguaggio può aggiungere informazioni sulle priorità umane, ma deve poi essere tradotto in vincoli operativi. Se un modello interpreta male un’intenzione, il rischio è che una generalizzazione sbagliata produca un comportamento inatteso. Un robot potrebbe evitare qualcosa che non deve evitare oppure trascurare un pericolo reale.
Che cosa manca prima di arrivare in salotto
Il MIT presenta risultati promettenti, non una certificazione di sicurezza. I test descritti sono simulazioni e non dimostrano che FLEX possa gestire ambienti domestici reali, persone in movimento, animali, oggetti sconosciuti o situazioni impreviste. Non sono sufficienti per concludere che il robot comprenda il senso comune allo stesso modo di un essere umano.
Resta inoltre da valutare la robustezza di un sistema che dipende da un LLM. Le interpretazioni possono essere ambigue, sensibili al contesto e difficili da verificare in anticipo. Per applicazioni di assistenza, soprattutto vicino a persone vulnerabili, servono controlli indipendenti, limiti di movimento, verifiche fisiche e la possibilità di chiedere chiarimenti quando l’intenzione non è abbastanza chiara.
Un altro punto riguarda il tempo di risposta. Cinque secondi possono essere ragionevoli per aggiornare una preferenza durante un compito lento, ma non per reagire a un pericolo improvviso. Le due funzioni non devono essere confuse: una cosa è apprendere una regola, un’altra è arrestare immediatamente un movimento rischioso.
La prospettiva più interessante
Mi colpisce soprattutto il cambio di domanda. Per anni abbiamo cercato modi sempre più semplici per dire alle macchine esattamente cosa fare. Qui i ricercatori provano a costruire un’interfaccia in cui non sia necessario esplicitare ogni dettaglio. Non è ancora il robot che comprende davvero la nostra casa, ma è un tentativo di ridurre la distanza tra il linguaggio quotidiano e la logica delle macchine.
La sfida futura sarà verificare che la capacità di generalizzare non si trasformi in un eccesso di sicurezza. Un buon assistente non dovrebbe soltanto intuire cosa intendiamo: dovrebbe anche sapere quando la propria interpretazione non basta. FLEX è un passo di ricerca in questa direzione, da valutare con attenzione mentre si passa dalle simulazioni agli ambienti reali.
Fonti e stato della ricerca
MIT News, comunicazione del 9 novembre 2026: AI-assisted learning platform helps robots reason beyond literal commands. Studio annunciato per la Conference on Robot Learning di novembre 2026: Flexible Language-Guided Representation Editing for Adaptive Robot Behavior. Al momento della comunicazione, il lavoro è presentato come studio destinato a una conferenza; non va confuso con una tecnologia commerciale già validata in abitazioni reali.

